攻坚Token极致性价比!新华三举办下一代智算关键技术创新论坛
2026-09-24 21:33:36 世界浙商
9月23日,云栖大会火热进行中,紫光股份旗下新华三集团联合产业伙伴成功举办"打造Token极致性价比——下一代智算关键技术创新论坛",来自阿里云、平头哥、英特尔、Broadcom、清程极智、是石科技等知名AI企业的技术专家齐聚一堂,围绕智算基础设施的关键技术攻坚与实践成果展开深度研讨,凝聚产业合力,探寻效能跃升路径。

立足产业新阶段
AI竞争迈入系统级效能比拼时代
当前,AI产业正从比拼模型参数、硬件卡数的粗放发展阶段,加速迈向规模化商用落地的攻坚期。规模扩容之下,单纯硬件堆叠的边际效益持续递减,训推成本高昂、集群协同效率不足正成为全行业面临的共同挑战。
新华三集团高级副总裁、网络产品线总裁乔剡在开场致辞中指出,智算产业在发展中面临的瓶颈无法仅依靠单一硬件迭代破解,唯有通过系统级创新、全栈技术协同与产业链联动,削减全链路资源损耗,方能夯实AI产业长期发展根基。
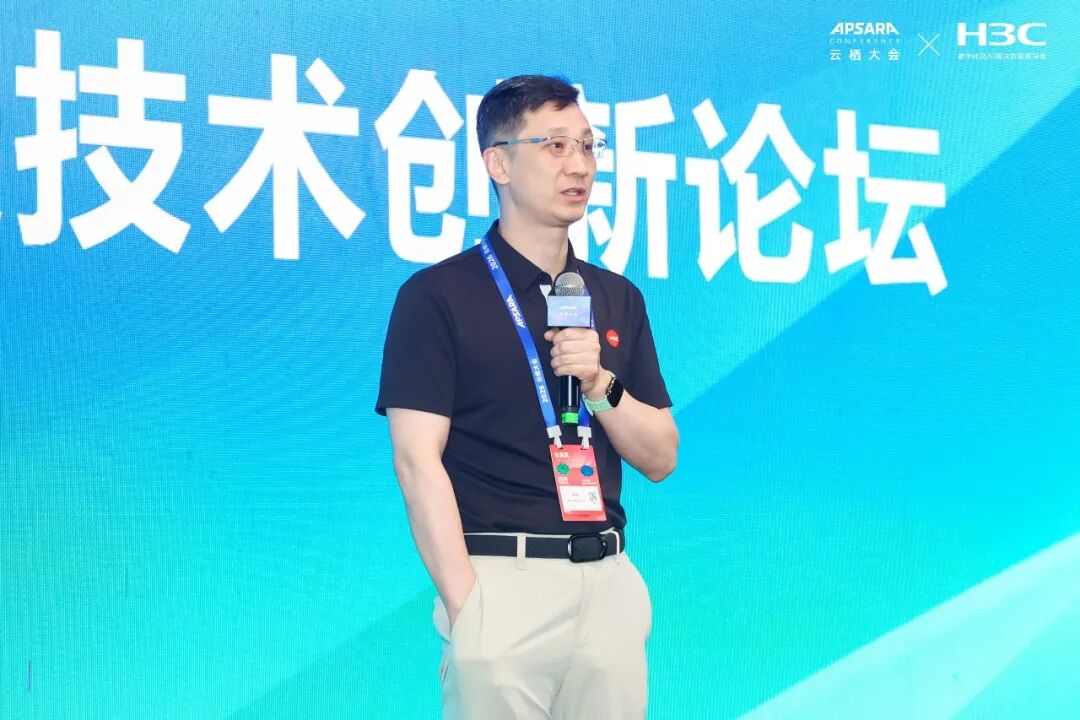
新华三集团高级副总裁、网络产品线总裁乔剡
阿里云专有云网络和安全负责人、资深技术专家张然随后发表致辞,他以云产业实践视角,阐述了智算建设与成本管控的产业思考,并呼吁产业链加强协同,共同推动大模型业务走向规模落地。
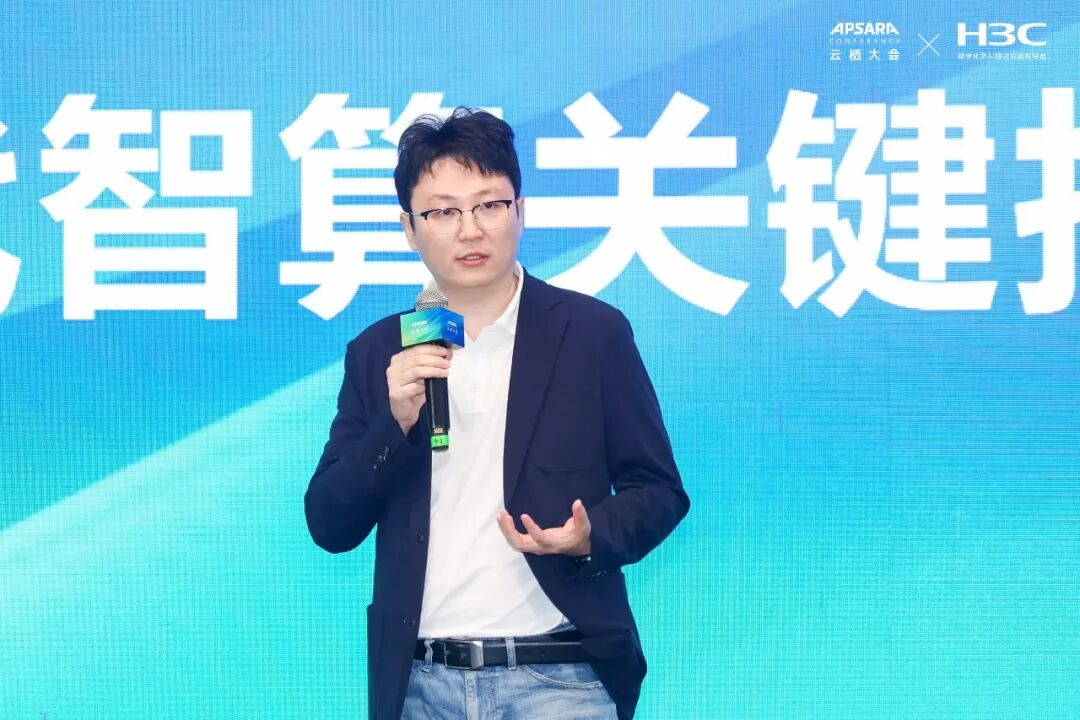
阿里云专有云网络和安全负责人、资深技术专家张然
多维度拆解
系统探寻TOKEN性价比实现路径
本次论坛围绕Token极致性价比这一核心主题,从超节点架构创新到整机协同优化开篇,进行算力底座的芯片层、联接层、存储层再到软件优化层的逐维拆解,全面呈现下一代智算基础设施的关键技术演进路径。
算力架构革新:从底层芯片到智算系统的效能释放
新华三集团先进技术研究部总经理朱仕银指出,超节点并非简单的算力堆叠,而是高速互联、供电散热与软件栈优化协同构成的系统工程。在Scale-Up高速互联层面,新华三在积极跟进国内外主流标准协议的同时,也在持续投入自研G-Link互连协议及技术架构创新,面向更大规模的GPU互联提升带宽、时延与可靠性;同时,在高密供电与液冷散热、训推软件优化等关键环节持续突破,通过互联架构、协议、通信软件及资源调度等协同优化,构建高带宽、低时延、高可靠的超节点算力底座,持续提升算力资源利用效率与系统整体性能。
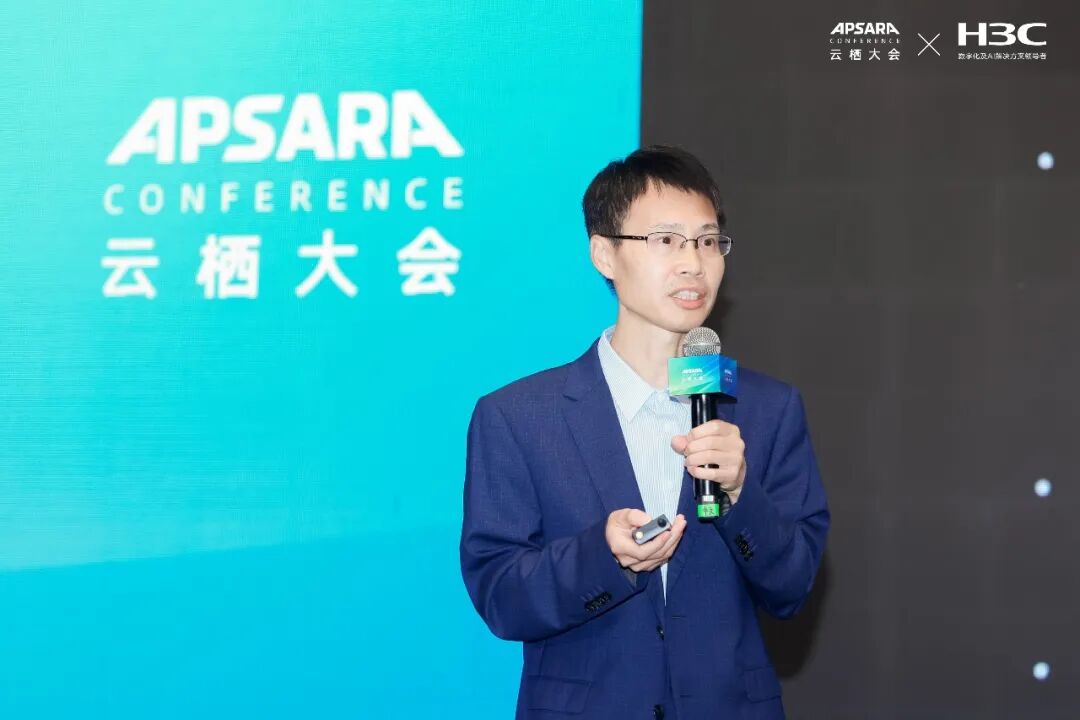
新华三集团先进技术研究部总经理朱仕银
英特尔数据中心集团首席软件工程师谢义分享了CPU+GPU异构协同的优化路径。面对智能体时代MoE热点漂移、KV Cache跨轮累积等挑战,通过异构负载均衡将热点专家卸载至CPU以降低尾延迟,通过至强DSA和QAT专用硬件加速KV Cache搬移和压缩,使GPU更聚焦核心计算,进一步释放整机效能。
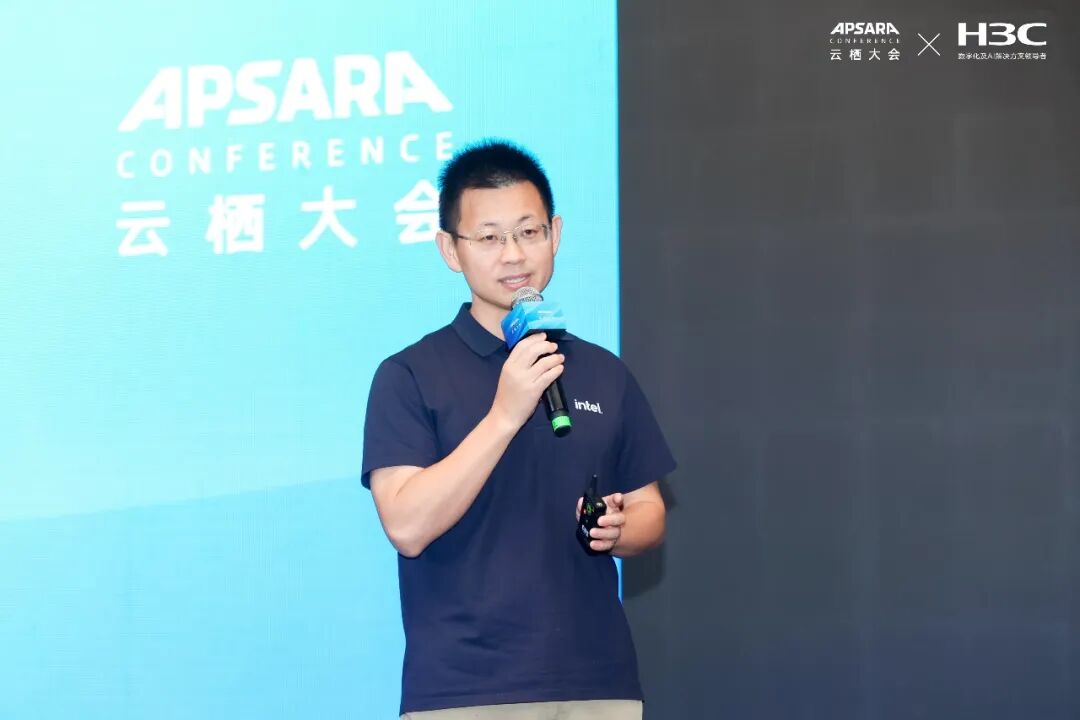
英特尔数据中心集团首席软件工程师谢义
智算网络跃升:全场景互联支撑算力规模扩展
网络是决定算力规模能否持续扩展、效能能否充分释放的关键变量。随着智算集群规模的不断扩大,推动整个智算网络架构从芯片到跨域的全链路演进。论坛围绕这一趋势,从底层芯片创新到开放生态构建再到跨域工程实践,逐层展开探讨。
阿里云网络研发高级技术专家李旅从产业视角给出判断,Agentic AI时代AI基础设施的评价标准正从"训练算力"转向"每Token成本×SLO",KV Cache正成为需网络化承载的热数据。基于这一变化,业内正在探索以Token效能为核心目标的推理网络新架构,而开放、统一的以太网,正是这一架构演进的产业共识底座。
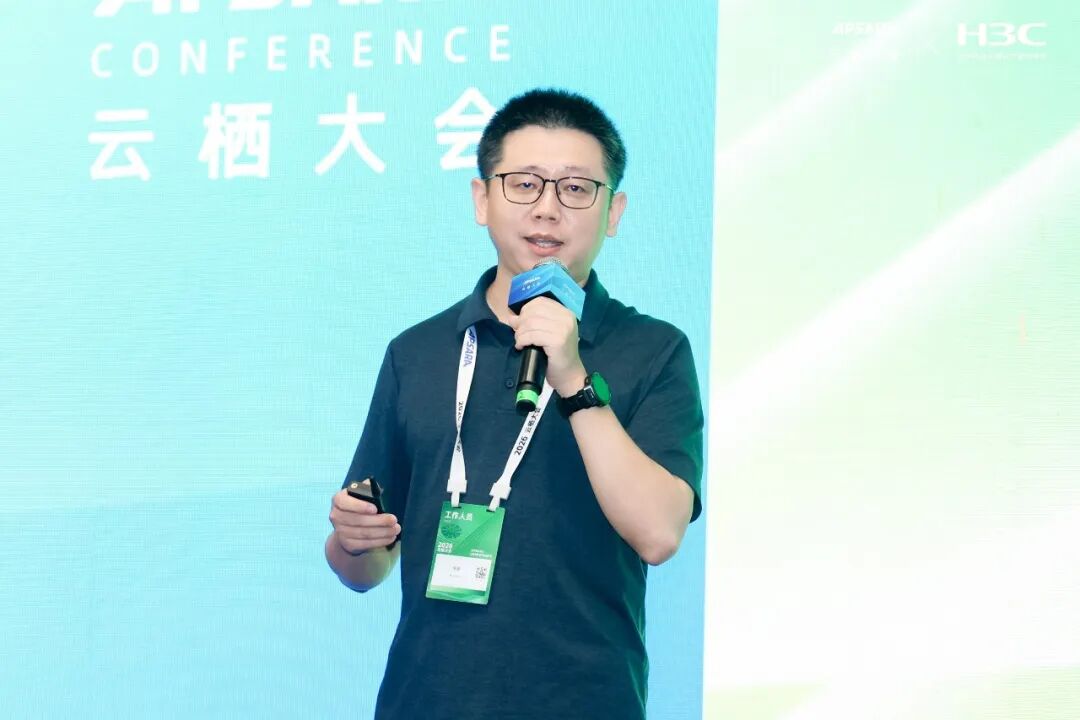
阿里云网络研发高级技术专家李旅
在底层芯片层面,网卡架构创新正在重塑节点内互联效率。平头哥半导体产品总监李旭慧分享了"Switch进网卡"的技术演进思路,通过将交换能力下沉至智能网卡,实现节点内计算与存储资源的高效直连,为超节点内部互联提供了新的技术路径。
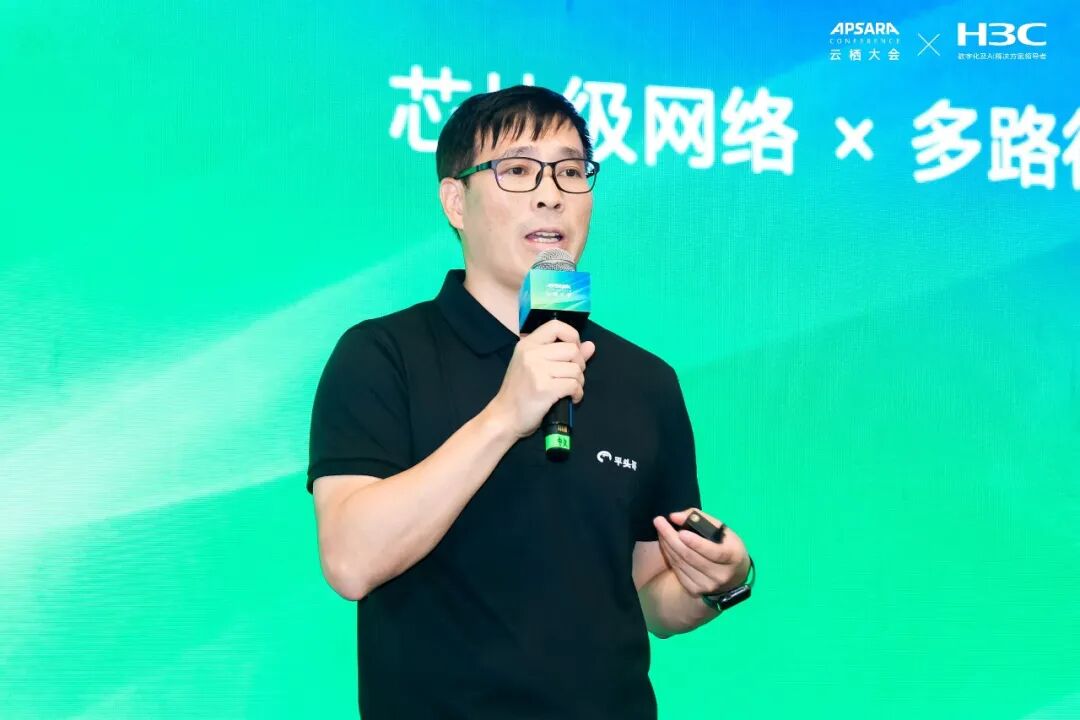
平头哥半导体产品总监李旭慧
博通高级产品经理刘婷婷介绍了开放以太网覆盖AI全场景互联的技术路线。从Scale-Up、Scale-Out再到Scale-Across,以太网凭借标准化优势与成熟生态,正在成为智算网络的统一底座,支撑算力规模从万卡到几十万卡的平滑扩展。
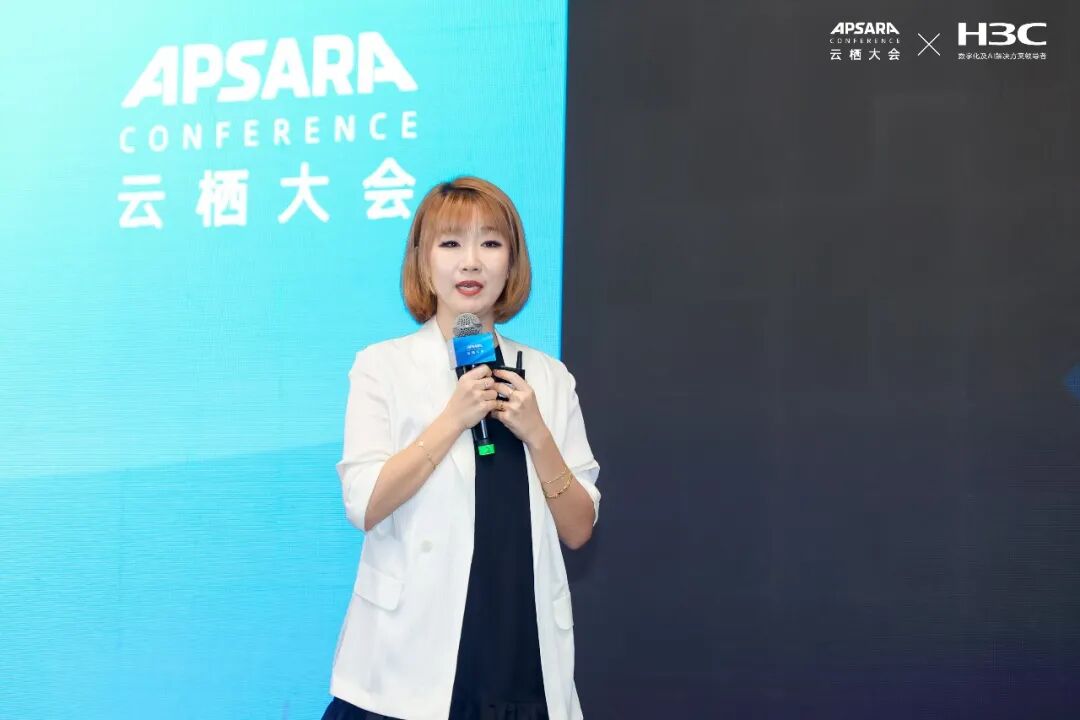
博通高级产品经理刘婷婷
针对跨域协同这一最复杂的场景,新华三集团网络产品线智算网络架构师蒋新红分享了新华三打造的跨域协同组网方案,以高速光互连为传输底座,结合确定性流量调度与近源拥塞控制,辅以端到端安全加密与故障无缝切换,将异地分散的算力聚合为统一资源池,支撑大规模分布式训推业务跨域稳定运行。
新华三集团网络产品线智算网络架构师蒋新红
存储架构创新:突破推理业务内存桎梏
智能体规模化应用后,推理环节生成的大量临时缓存数据给内存资源带来巨大压力,KV Cache正成为拉高Token成本的关键瓶颈。新华三集团存储产品线首席架构师陈钊指出,当前推理存储面临加载效率与架构瓶颈两大核心挑战,传统存储架构已难以匹配智能体时代的高并发推理需求。
针对上述挑战,新华三推出KV Cache整体解决方案,通过多层级差异化存储加速架构,实现KV Cache的高效访问与灵活共享,显著降低推理环节内存成本;方案向上兼容多种推理引擎与异构算力平台,推动存储从成本制约因素向效率提升杠杆转变。
新华三集团存储产品线首席架构师陈钊
业务落地优化:打通 AI 规模化应用最后一公里
硬件底座的效能,最终需要通过软件体系承接,方能转化为业务生产力。论坛聚焦国产算力软件适配与智能体长周期训练框架两大落地痛点,探寻从硬件性能到业务价值的转化路径。
在国产算力落地方面,硬件易得、软件生态欠缺是行业普遍面临的现实困境。清程极智联合创始人师天麾分享了国产算力软硬协同的破局思路,提出通过补齐广域兼容的推理引擎等软件层能力、构建科学评测与智能路由类平台支撑,推动国产算力从可用走向好用。
清程极智联合创始人师天麾
智能体长程任务对训练框架提出了更高要求,传统面向短轨迹交互的训练框架在长轨迹、多轮交互等场景下面临新的适配挑战。是石科技首席科学家李俊涛指出,当前智能体训练主要面临三方面挑战:模型与训练框架的适配、长上下文处理与长轨迹训练之间的衔接,以及训练过程对 Harness 的高度敏感。业内正在通过统一的强化学习训练框架、异步强化学习架构等技术探索,降低长轨迹训练中的上下文干扰,提升训练效率,并进一步完善支撑智能体工程化落地的训练基础设施。
是石科技首席科学家李俊涛
Token极致性价比的实现,从来不是单点技术的突破,而是全链路的系统工程。面向未来,新华三集团将持续深耕下一代智算关键技术,与产业链伙伴一道,以系统级创新回应AI时代的产业命题,让算力真正成为百行百业智能化升级的坚实底座,赋能AI产业高质量发展。